故障复盘
RTX 5090 工作站:从 CUDA 到本机出图
2026-09-08
- 现象
- 驱动能看见 RTX 5090,旧 PyTorch / 整合包没有 sm_120,软件起不来或只能走 CPU。现场需要本机生成、训练、管模型都能用上这张卡。
- 环境
- Windows 11 工作站 · NVIDIA RTX 5090 32GB · CUDA 12.8 Toolkit
- 排查
- 先用 nvidia-smi 确认驱动认卡,再在独立 Python 环境里检查 PyTorch 的 CUDA 架构列表。驱动里能读到设备名,不等于当前轮子带了 Blackwell 的 sm_120。
- 原因
- RTX 5090 是 Blackwell,计算能力 12.0(sm_120)。旧 PyTorch / 整合包只编到更早架构,所以能看见卡却跑不了 GPU 算子。系统 nvcc、驱动申报的最高 CUDA、pip 包里的 cu128 / cu130 runtime 是三回事,混装会互相覆盖。
- 解决
- 用独立 cu128 环境先证明这张卡能算;ComfyUI、Forge Neo、kohya_ss 分环境安装,不要塞进同一个 venv。模型只放一份公共目录。用公开 SD1.5 Checkpoint 跑一次 512×512 文生图,确认 ComfyUI 真正调到了 5090。
- 总结
- 独立 cu128 环境验证 Capability (12,0) / sm_120;三套应用分环境启动;公共模型目录下 ComfyUI 实际出图通过。
现场是一台 Windows 11 + RTX 5090 的本地生成式工作站。目标不是「装好一个出图网页」,而是驱动、CUDA、PyTorch 和三套应用都能稳定认到同一张卡,并且用公共模型目录真正跑通一次文生图。
不含主机地址、账户口令、整机品牌清单和可识别的目录树。
排查
链路可以看成:
Windows 11
  → NVIDIA 驱动
  → CUDA Toolkit / cuDNN / PyTorch
  → ComfyUI / Forge Neo / kohya_ss
  → 数据盘公共模型目录
  → 文生图 / 视频工作流 / LoRA 训练
三套软件各自带 Python / PyTorch,不要塞进同一个 venv。系统里的 nvcc、驱动申报的最高 CUDA、pip 包里的 cu128 / cu130 runtime 是三回事。
nvidia-smi能看到 5090 和显存,再装别的。- CUDA Toolkit 12.8 走 NVIDIA 默认位置,不把 Toolkit 挪盘。
- 安装匹配的 cuDNN,读版本头文件确认。
- 基础 Python(现场指定过 3.10)只当工具链:Git、VC++ Runtime、7-Zip、FFmpeg、uv。
- Hugging Face CLI 单独建环境,缓存指到数据盘,避免把模型堆在系统盘。
- 再单独建一个 PyTorch CUDA 12.8 验证环境,只做认卡,不拿它跑 ComfyUI。
原因
Blackwell 需要 sm_120(Compute Capability 12.0)。那是 GPU 架构编号,不是「CUDA 12.0」。驱动里能读到设备名,不等于当前 PyTorch 轮子带了这个架构。
在验证环境里跑:
python -c "import torch; print(torch.cuda.is_available(), torch.cuda.get_device_name(0), torch.cuda.get_device_capability(0), torch.cuda.get_arch_list())"预期:True、设备名含 RTX 5090、capability 为 (12, 0)、arch list 含 sm_120。再做一次小矩阵 GPU 运算。过了再装应用。
本次现场独立环境:PyTorch 2.11.0+cu128,CUDA runtime 12.8,GPU TEST PASS。
解决
三套应用分环境安装
| 软件 | 用途 | 访问 | 现场验证 |
|---|---|---|---|
| ComfyUI Desktop | 节点式文生图 / 视频工作流 | 本机 Desktop | Python 3.13 + PyTorch cu130,认到 5090 / sm_120,实际出图 |
| Forge Neo | 表单式快速出图 | 本机 127.0.0.1:7860 |
PyTorch cu130,cuda:0,WebUI 启动 |
| kohya_ss | LoRA / DreamBooth 训练 | 本机 127.0.0.1:7862 |
Python 3.11 + PyTorch cu128,认到 sm_120,GUI 启动 |
ComfyUI Desktop 选本地 NVIDIA 实例,首次安装让它自己拉 Python / PyTorch,不要在安装向导里下入门大模型,模型后面统一放到公共目录。
Forge 用独立 venv,启动脚本加上公共模型引用(例如 --model-ref 指向数据盘模型根目录)。RTX 50 系上未强行开 xformers,保持当时能启动的组合。
kohya 用 uv 拉独立环境,WebUI 绑在回环地址的固定端口,不默认监听到局域网以外。
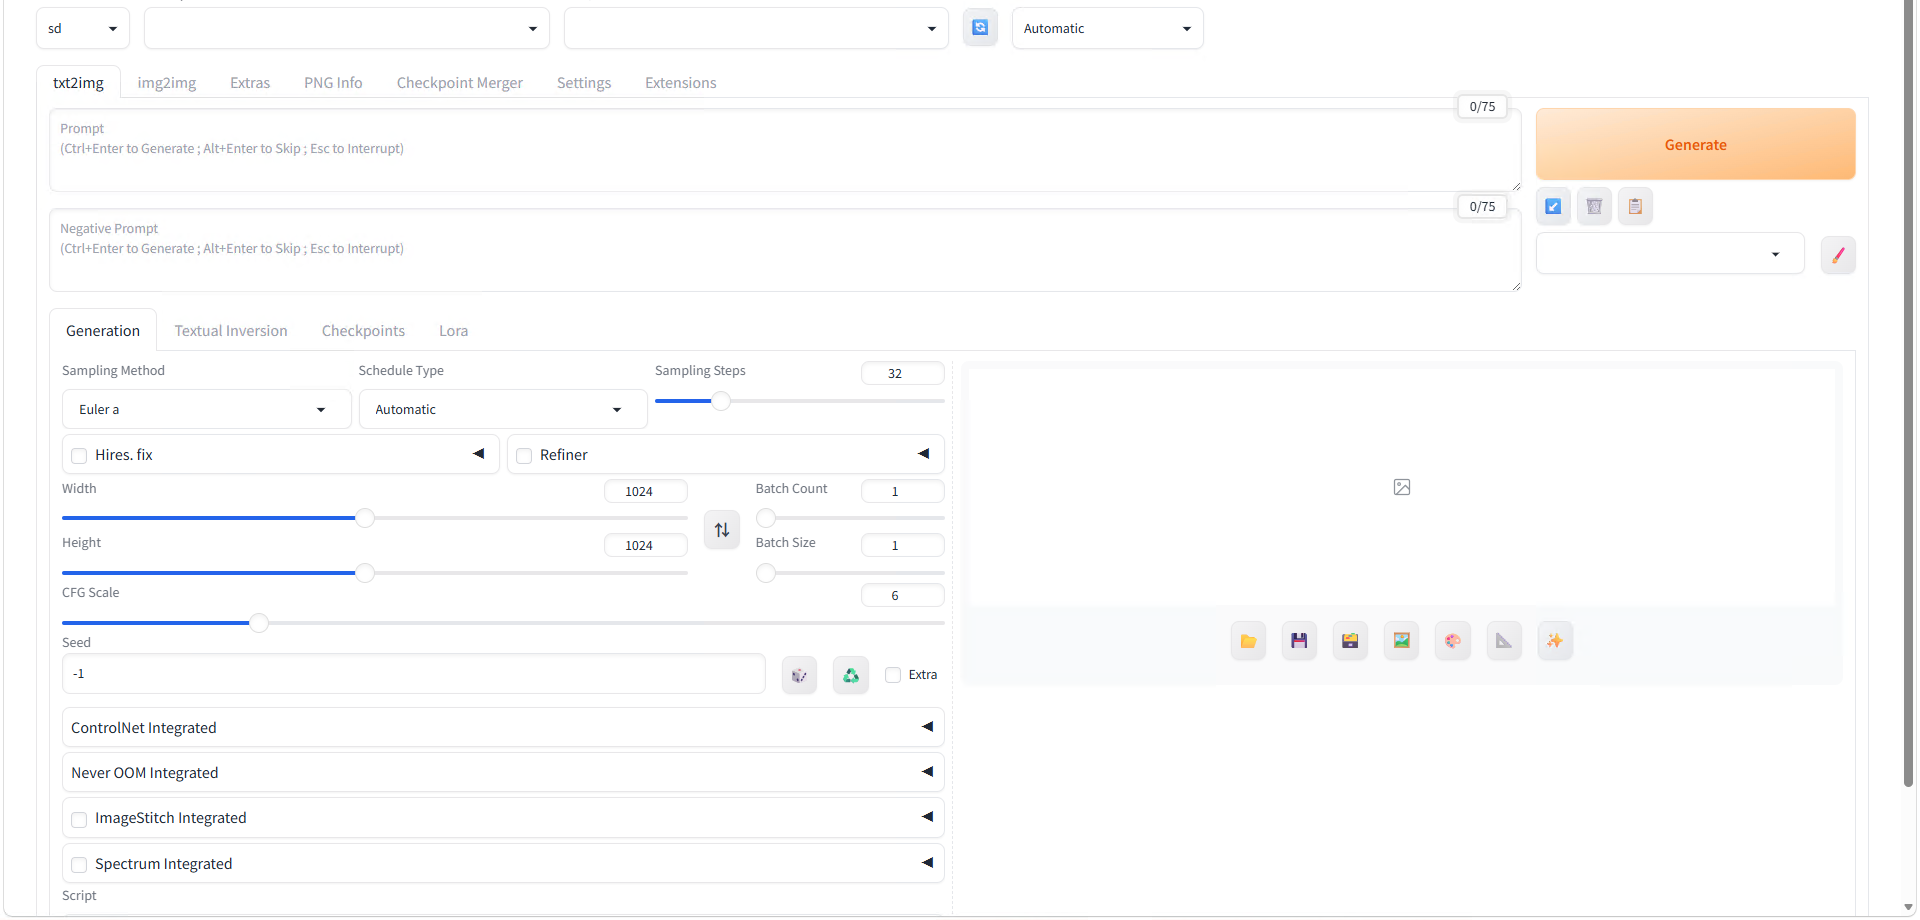
Forge Neo 本机 WebUI。装完要能打开出图表单,不要求这一步就出图。
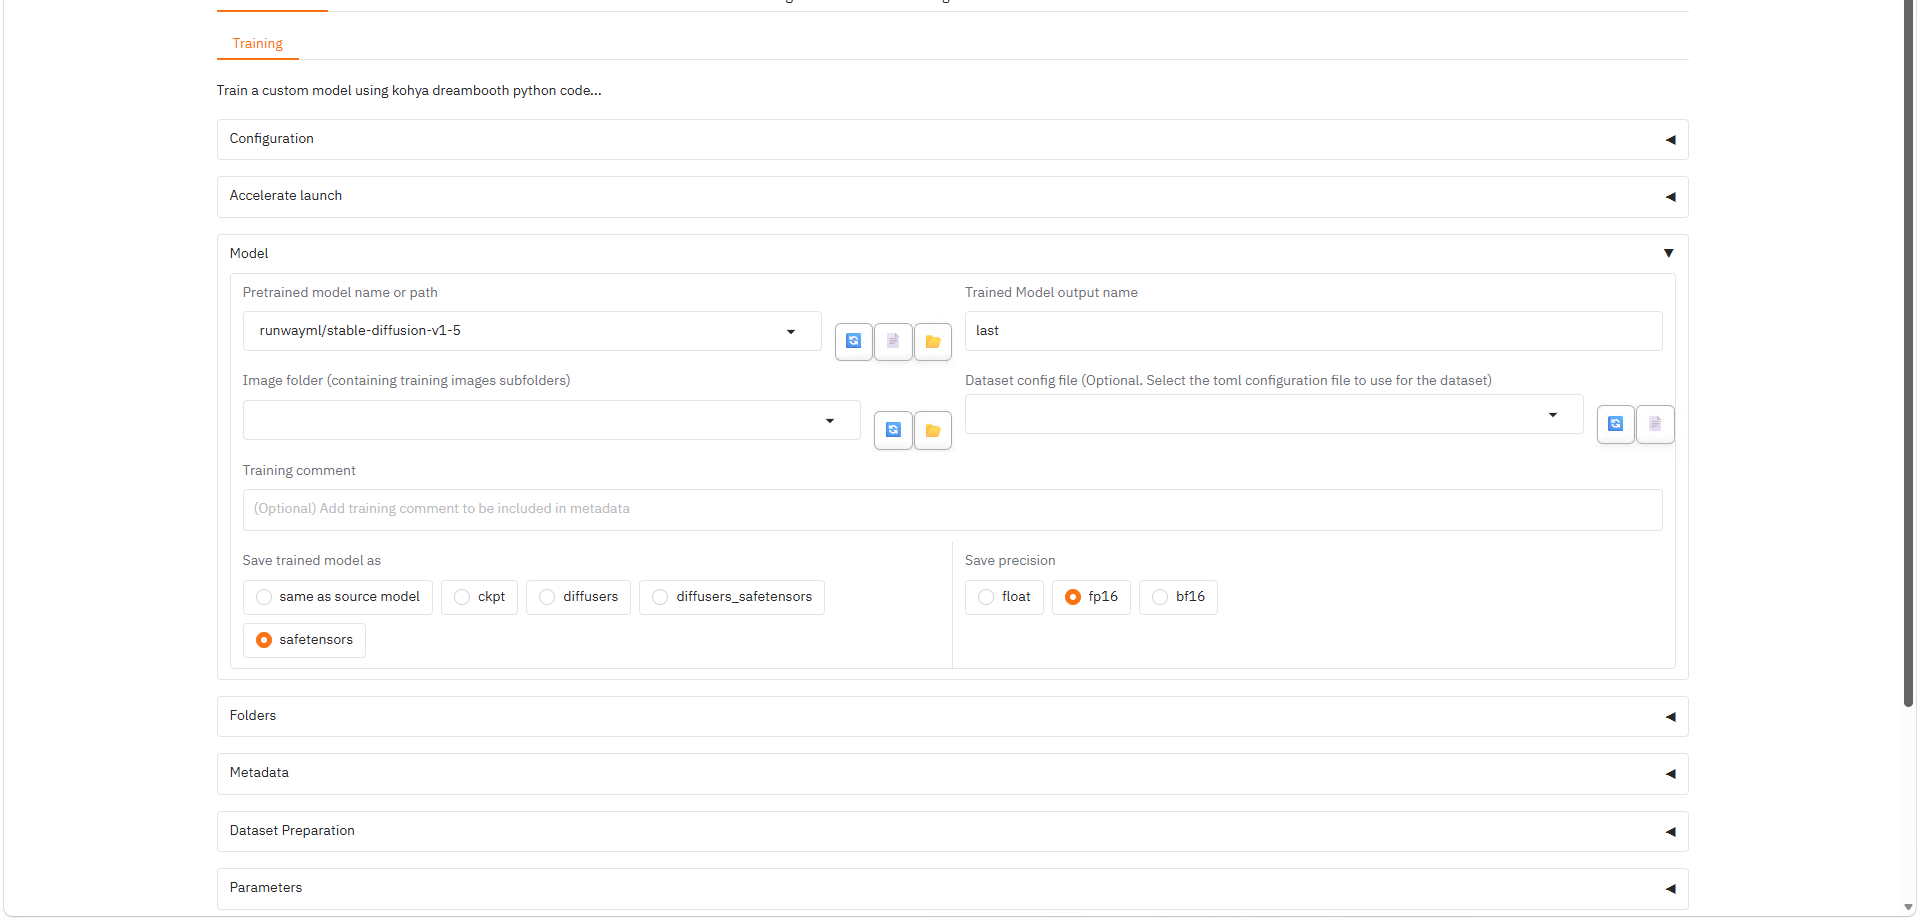
kohya_ss 训练界面。装完要能打开,并确认环境认到同一张 5090。
模型只放一份
ComfyUI 与 Forge 指向同一套数据盘目录,避免三份 Checkpoint:
- Checkpoint / 基础模型
- LoRA
- VAE
- 放大 / ControlNet / embedding
- Hugging Face 缓存
ComfyUI 用 extra_model_paths.yaml 把分类目录映射过去;Forge 用启动参数引用同一根目录。缺模型时先对目录、刷新列表,不要先重装 GPU 栈。
工作流模板若绑定另一类模型(特定 UNet / 视频模型),和 SD1.5 Checkpoint 不是同一套。对不上就换匹配模型或标准 SD1.5 工作流。
出图验证
用公开的 SD1.5 Checkpoint 做一次最小闭环,证明 ComfyUI 真正调到了 RTX 5090:
| 项 | 本次 |
|---|---|
| 模型 | v1-5-pruned-emaonly.safetensors |
| 分辨率 | 512 × 512 |
| Steps | 20 |
| CFG | 7.0 |
| Sampler / Scheduler | euler / simple |
节点:Checkpoint → 正/负 CLIP 编码 → 空 Latent → KSampler → VAE Decode → Save Image。
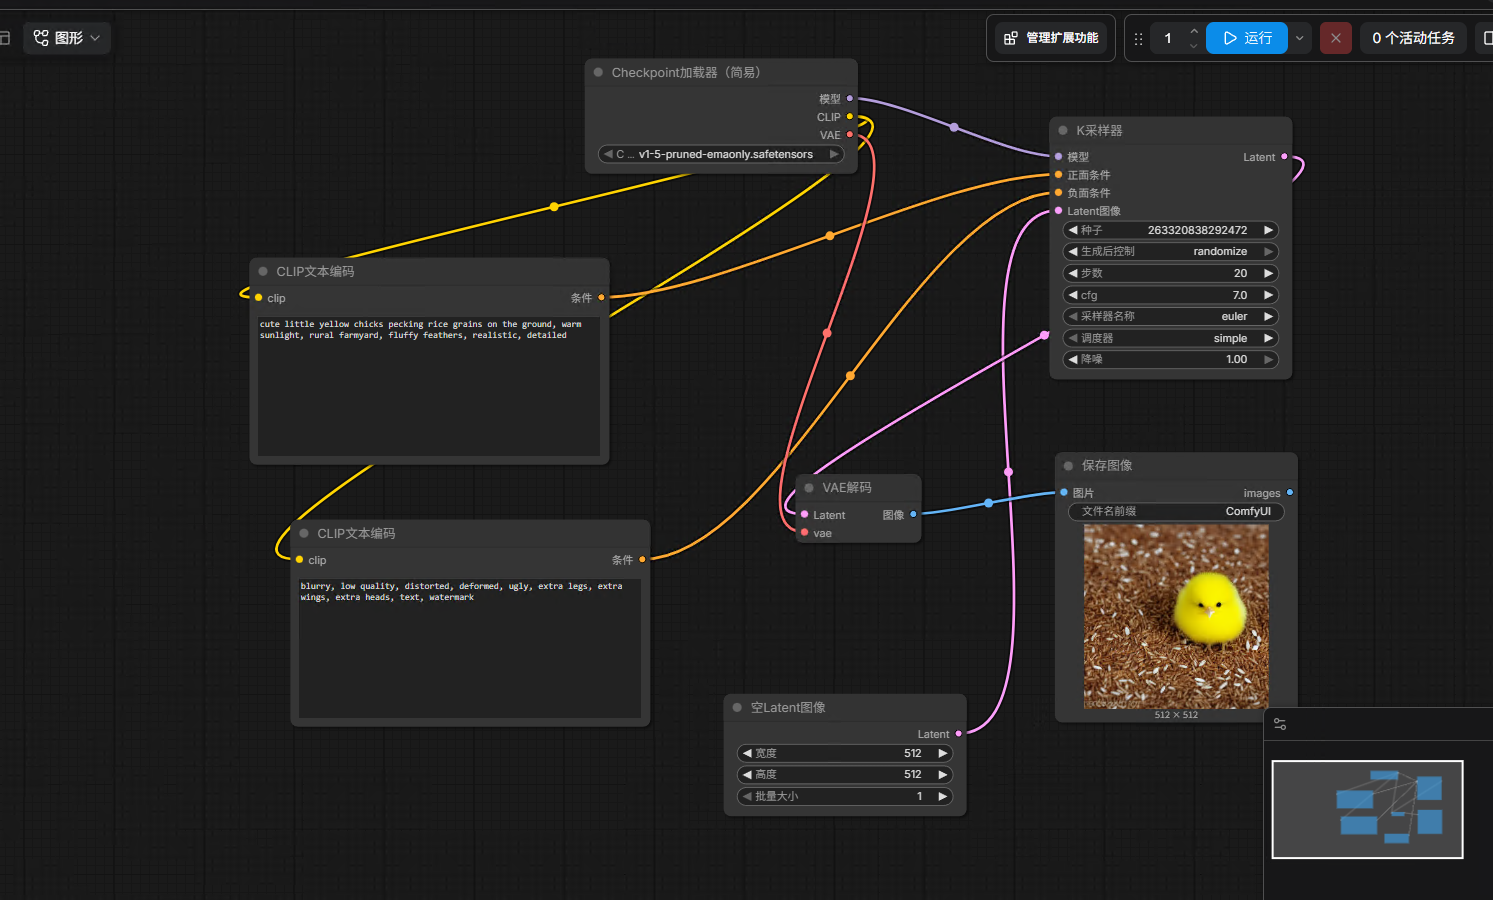
Checkpoint 加载成功,采样、解码、保存都跑完,512×512 测试图落盘。这是「卡能算」到「应用能用」的验证点。
总结
常见坑:
| 现象 | 先查 |
|---|---|
| ComfyUI 提示缺模型 | 公共目录对应分类里有没有文件,刷新后再选 |
| 模板报缺 UNet / CLIP | 模板不是 SD1.5 这条链,换匹配模型 |
| Forge 提示没有任何模型 | Checkpoint 目录是空的 |
| 7860 / 7861 同时占着 | 起了两份 Forge,留下固定端口那份 |
| Hugging Face 下载超时 | 现场代理策略,不要改成系统全局永久代理 |
PowerShell 禁止 Activate.ps1 |
直接用该 venv 的 python.exe 绝对路径 |
以后升级时,不要把三套软件的 PyTorch 互相覆盖。升驱动或 CUDA 前先备份工作流和配置,再在验证环境里确认 sm_120 仍在。常用 ComfyUI 工作流存成 JSON,下次直接加载。